
Optimierung der Traubenzahlschätzung auf Weinbergsebene Dies ist die Übersetzung eines Fachartikels, der ursprünglich in Englisch verfasst wurde.

Die frühzeitige Schätzung der durchschnittlichen Traubenanzahl pro Rebstock ist entscheidend für die Weinbergsplanung, Investitionen sowie für die Vermarktung (Laurent et al., 2021). Obwohl die Probennahme zur Schätzung der Traubenanzahl pro Rebstock im Weinbau weitgehend Routine ist, existiert kein standardisiertes Probenahmeprotokoll, welches als Referenz benutzt werden könnte. Dies führt zu unterschiedlichen Methoden und Resultaten unter Praktikern. In dieser Studie wird demnach der Einfluss unterschiedlicher Probenahmeprotokolle auf die resultierenden Schätzfehler untersucht, um anschließend Praxisempfehlungen für eine optimale Probenahme zu geben.
Unterschiede zwischen Probenahmeprotokollen
Praktiker aus mehreren Organisationen wurden nach den von ihnen angewandten Probenahmemethoden zur Schätzung der durchschnittlichen Traubenzahl pro Rebstock befragt, und es wurden erhebliche Unterschiede festgestellt. Diese Unterschiede beziehen sich hauptsächlich auf:
- Das Zählprotokoll, welches fehlende Rebstöcke einbezieht oder weglässt.
- Die Anordnung der zur Probe ausgesuchten Rebstöcke, welche in unterschiedlichen Größen gruppiert werden können (eine unterschiedliche Anzahl aufeinanderfolgender Rebstöcke, die entlang einer Reihe zusammen beprobt werden).
- Die Gesamtzahl der pro Fläche beprobten Rebstöcke.
Die folgenden Abschnitte geben (den) Praktikern einige Empfehlungen auf der Grundlage experimenteller Ergebnisse zur Schätzung der durchschnittlichen Traubenzahl pro Rebstock auf Feldebene.
Die Schätzung sollte sich auf die Traubenzahl konzentrieren und fehlende Reben ignorieren
Bei der Durchführung von Schätzungen durch Stichproben muss die Stichprobengröße an die zu schätzende Variable angepasst werden. Folglich sollten zwei Variablen unterschiedlicher Eigenschaften mittels angepasster Probenahmeprotokolle geschätzt werden. Im Weinbau zum Beispiel, unter der Befolgung eines Probenahmeprotokolls, welches bei fehlenden Rebstöcken 0 Trauben zählt, werden im Prinzip zwei Ertragskomponenten gleichzeitig geschätzt: sowohl der Anteil der fehlenden Rebstöcke als auch die Anzahl der Trauben. Angesichts der grundsätzlich unterschiedlichen Natur dieser beiden Ertragskomponenten, oder Variablen, sollten sie jedoch unabhängig voneinander mit spezifischen Protokollen beprobt werden.
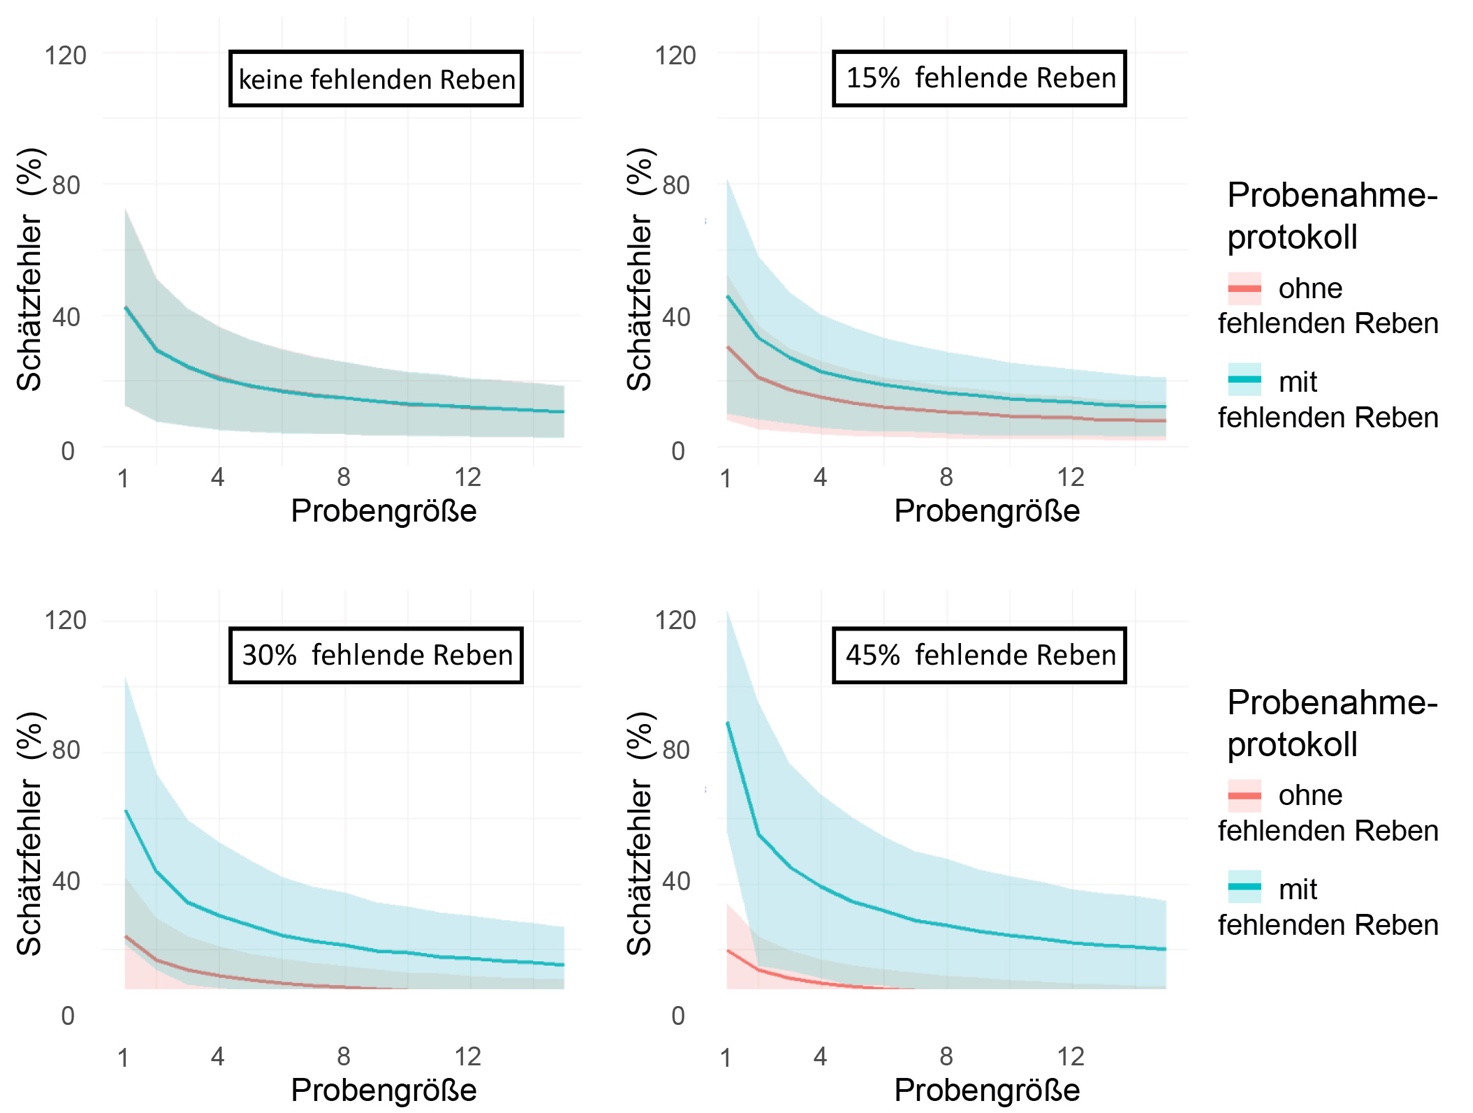
Wie in den vier Graphen in Abbildung 1 zu sehen ist, sinkt der Schätzfehler logischerweise mit zunehmender Stichprobengröße (also mit der Anzahl der tatsächlich beprobten Rebstöcke), unabhängig vom Probenahmeprotokoll. Die Abbildung zeigt auch, dass bei einer Zunahme der in der Zählung einbezogenen fehlenden und toten Rebstöcke in einem Feld, größere Fehler in der Schätzung der durchschnittlichen Traubenzahl pro Rebstock (in blau) auftreten. Dieses Phänomen verdeutlicht die Notwendigkeit, jede der beiden Ertragskomponenten unabhängig zu proben, um Schätzfehler zu reduzieren, insbesondere wenn der Anteil fehlender Rebstöcke auf den Feldern erheblich ist. Zur Verdeutlichung sei gesagt, dass die hier gezeigten Felder exemplarisch sind, allerdings stimmen die Ergebnisse mit den in realen Weinbergen gewonnen Erkenntnissen überein
Probenahmen sollten über mehrere Probebereiche verteilt werden
Ertragskomponenten sind oft räumlich organisiert, was bedeutet, dass eng benachbarte Rebstöcke eher ähnliche Eigenschaften aufweisen als weiter Auseinanderliegende. Im Fall der Traubenanzahl pro Rebstock ist es wahrscheinlicher, dass zwei dicht gepflanzte Rebstöcke eine ähnliche Anzahl von Trauben aufweisen. Durch die Probenahme an aufeinanderfolgenden Rebstöcken an einer einzigen Stelle besteht das Risiko, die Traubenzahl auf Feldebene zu überschätzen (oder zu unterschätzen), wenn dieser Bereich etwas mehr (oder etwas weniger) Trauben als der Durchschnitt aufweist. Es empfiehlt sich daher, die Beobachtungen auf mehrere (mindestens zwei oder drei) Bereiche zu verteilen, um dieses Risiko zu minimieren.
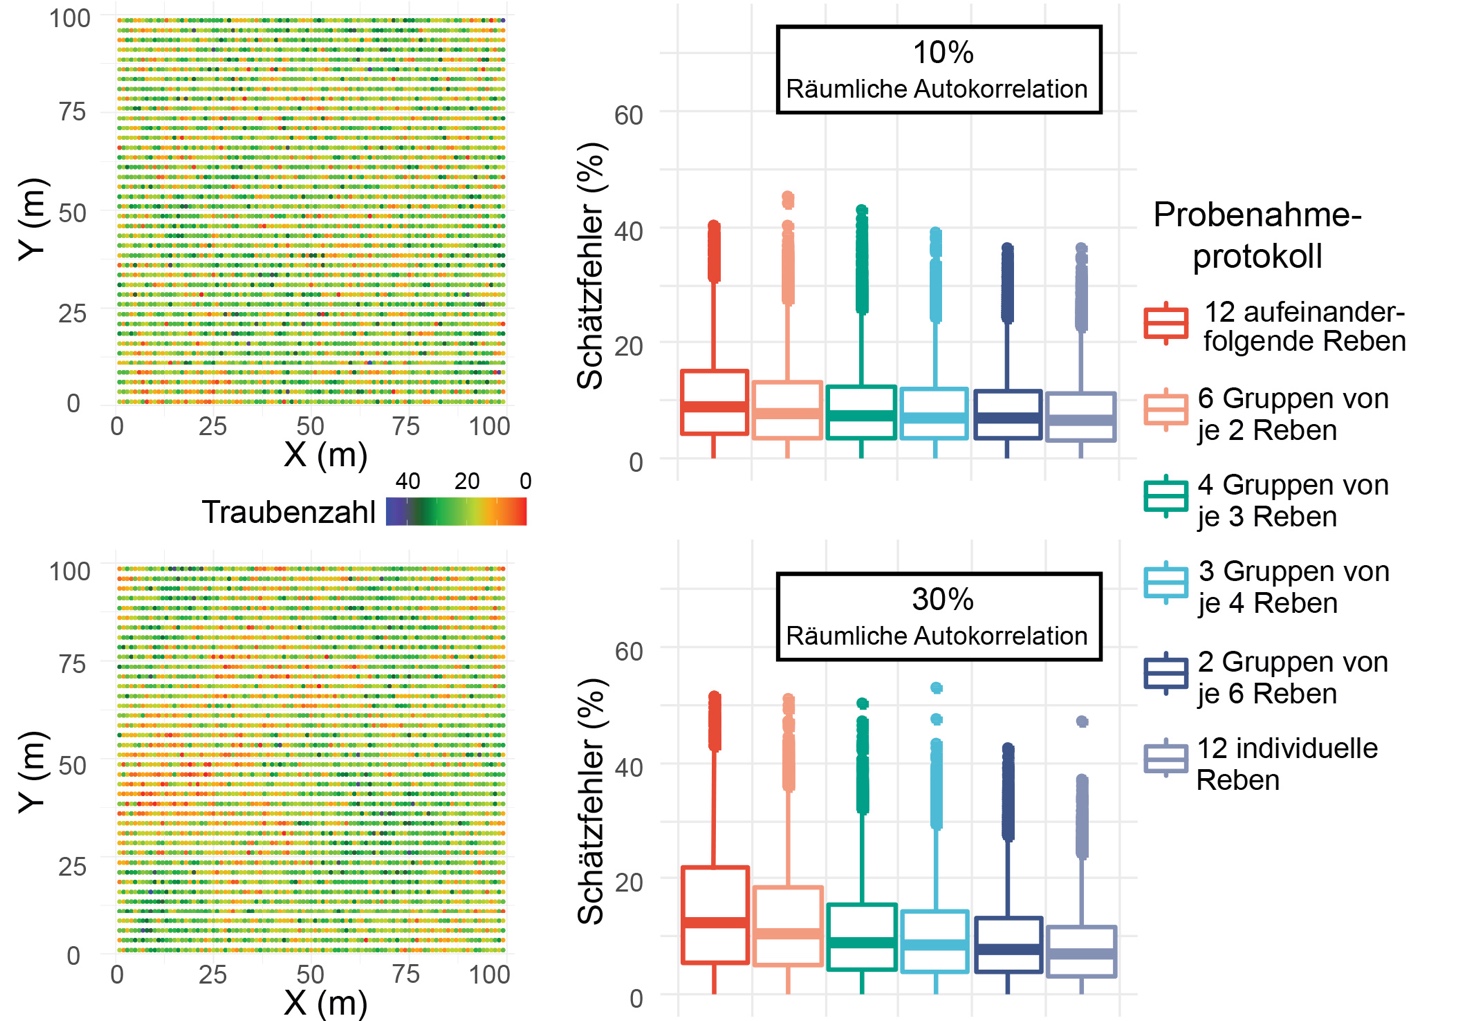
Abbildung 2 zeigt zwei Weinbergsflächen. Im oberen Feld ist die Anzahl der Trauben pro Rebstock wenig räumlich organisiert: Rebstöcke mit vielen Trauben befinden sich neben nahegelegenen Rebstöcken mit wenigen Trauben. Im unteren Feld ist die Anzahl der Trauben pro Rebstock stärker räumlich strukturiert: Rebstöcke mit unterschiedlichen Traubenanzahlen bilden isolierte Bereiche. In beiden Feldern werden jeweils sechs Probenahmeprotokolle verglichen, bei denen 12 Rebstöcke über 1, 2, 3, 4, 6 oder 12 Probebereiche verteilt werden.
In beiden Feldern sind die Schätzfehler höher, wenn die zur Probe selektierten Rebstöcke innerhalb eines einzigen Bereiches gruppiert werden (roter Boxplot), im Vergleich zu einer Verteilung auf zwei Probestellen. Abbildung 2 zeigt, dass bei gleicher Anzahl beobachteter Rebstöcke die Schätzfehler umso geringer sind, je mehr die beprobten Rebstöcke auf eine größere Anzahl von Probebereichen verteilt werden. Dieses Phänomen ist noch ausgeprägter, wenn die Anzahl der Trauben pro Rebstock räumlich autokorreliert ist, wie die größeren Schätzfehler im Feld mit 30 % räumlicher Autokorrelation zeigen.
Anpassung der Probengröße and der Probenvariabilität
Der letzte Teil dieses technischen Berichts befasst sich mit der Beziehung zwischen Schätzfehler, Stichprobengröße und Stichprobenvariabilität. Die Stichprobenvariabilität wird hier in Form des Variationskoeffizienten (CV) ausgedrückt. Dieser Koeffizient wird einfach berechnet, indem die Standardabweichung (Standard Deviation) der Stichprobe durch deren Mittelwert (Mean) geteilt wird (Gleichung 1):
Dies ist eine standardisierte Methode zur Quantifizierung der Streuung von Werten innerhalb einer Stichprobe. Die statistischen Details der Methode befinden sich in dem Artikel, auf dem dieser technische Bericht basiert
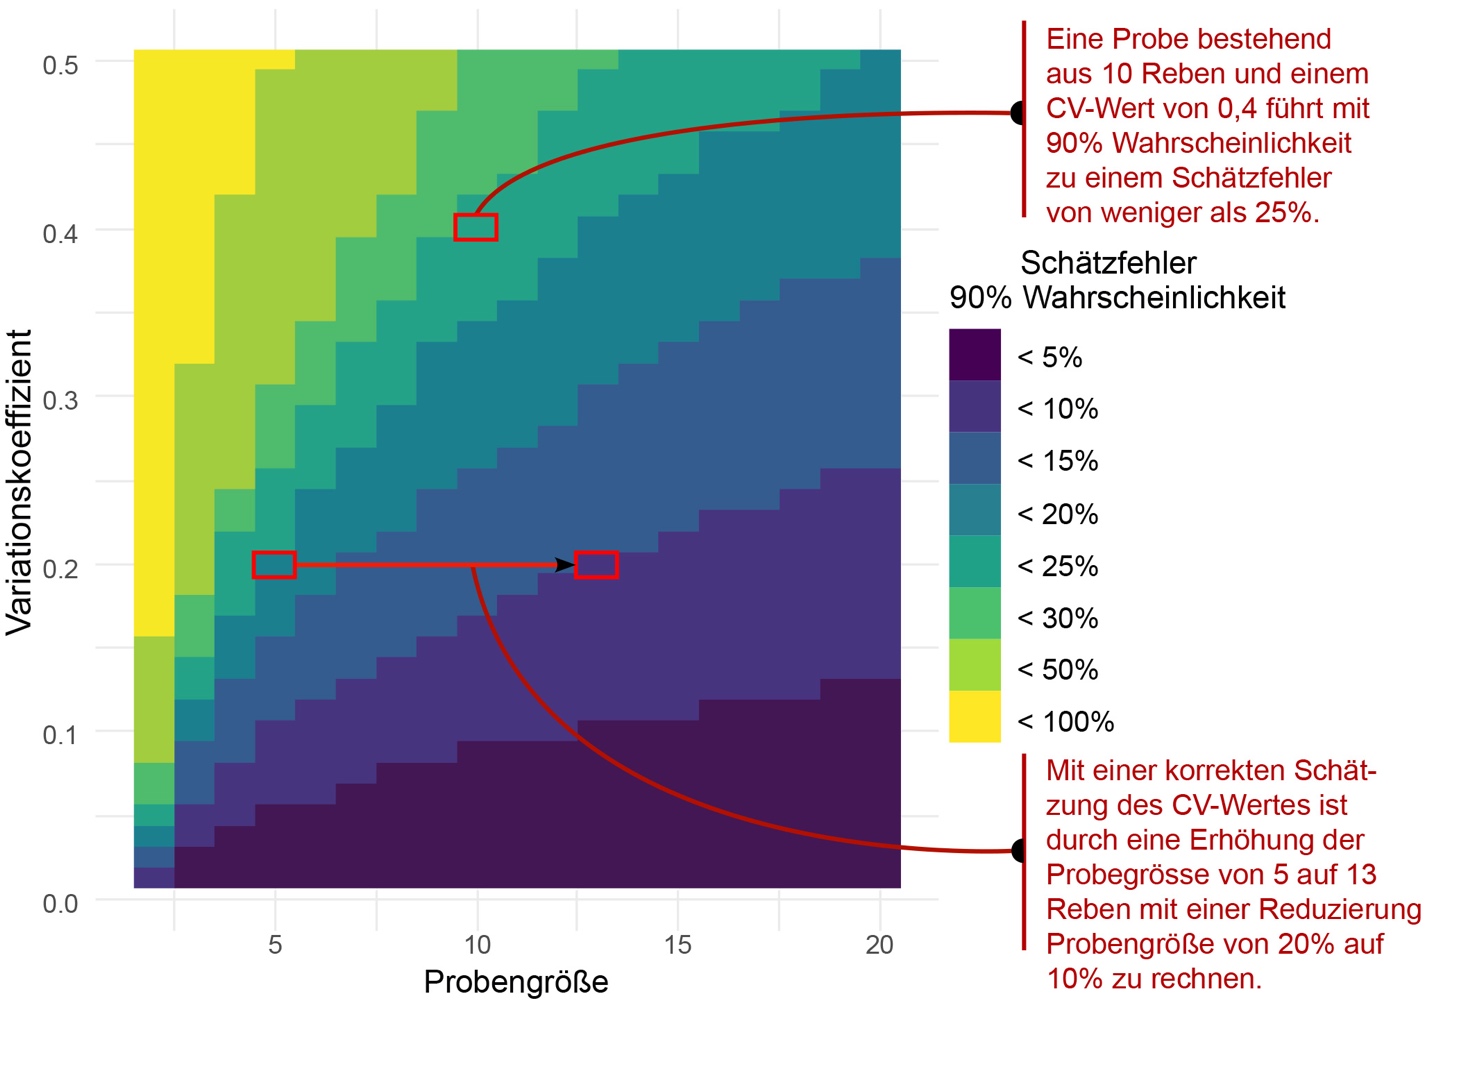
Abbildung 3 zeigt, wie sich bei einer gegebenen Stichprobengröße die Schätzfehler mit dem Variationskoeffizienten (CV) der Stichprobe ändern. Sie zeigt auch, wie die Variabilität (dargestellt durch den CV) von Beobachtungen an wenigen Reben verwendet werden kann, um eine geeignete Stichprobengröße zu bestimmen, um so einen definierten Schätzfehler zu erreichen. Je geringer die Variabilität der Messungen innerhalb einer Stichprobe, desto exakter ist die Schätzung. Eine stark variierende Probe (hoher CV) bedeutet, dass eine signifikante Feldvariabilität vorhanden ist, die mit einem hohen Fehlerrisiko im Ergebnis der Analyse verbunden ist. Daher ist es ratsam, bei einer hohen Variabilität der Proben die Stichprobengröße zu erhöhen, um hohen Schätzfehlern entgegenzuwirken. Zusätzlich bring die Erhöhung der Probenanzahl bei hoher Stichprobenvariabilität weitere Vorteile. Sofern sich der CV der Stichprobe nicht ändert, reduziert eine Erhöhung der Probenanzahl von 5 auf 13 (Abbildung 3) die obere Grenze des Konfidenzintervalls für Schätzfehler von ~39% auf ~22%, wenn der CV 0,4 beträgt, und nur von ~19% auf ~11%, wenn der CV 0,2 beträgt.
Durch die Berechnung des CV und unter Verwendung der Information aus Abbildung 3 ist es möglich, die Qualität einer Probe in Echtzeit zu beurteilen. Der Praktiker kann dann entscheiden, ob die Probennahme fortgesetzt werden soll, indem er die Stichprobengröße identifiziert, die bei gleichem Variationskoeffizienten die gewünschte Präzision (oder Schätzfehler) liefert. Diese Methode könnte auch helfen, die Weinbergsflächen zu identifizieren, bei denen die erforderliche Stichprobengröße zur Gewährleistung der gewünschten Präzision nicht erreichbar ist, sodass die Probenahme hier gestoppt wird, und man sich auf andere, besser geeignete Flächen konzentrieren kann. Es ist zu beachten, dass es notwendig ist, sich vertikal im Diagramm zu orientieren, wenn die Variationskoeffizienten durch die neuen Messungen geändert werden. Zur besseren Lesbarkeit ist eine tabellarische Form dieser Abbildung in einem Anhang frei verfügbar (siehe die Zenodo Quellenangabe
Fazit
Diese Studie hebt hervor, was man tun oder nicht tun sollte, wenn man die durchschnittliche Traubenanzahl pro Rebstock durch Probenahmen auf Weinbergsflächen schätzen möchte. Erstens empfiehlt es sich ein angepasstes Stichprobenprotokoll für jede Ertragskomponente zu verwenden. Obwohl es verlockend sein mag, gleichzeitig die Anzahl der fehlenden Rebstöcke und die durchschnittliche Anzahl der Trauben pro Rebstock zu erfassen, haben diese beiden Komponenten unterschiedliche Eigenschaften und erfordern daher jeweils spezifische Protokolle. Die zweite Empfehlung bezieht sich auf die Organisation der Probestellen. Während es möglich ist, dass diese aus mehreren aufeinanderfolgenden Rebstöcken bestehen, um etwa diese Arbeit besser in den Betriebsablauf zu integrieren, sollten mindestens 2 oder 3 Probebereiche vorhanden sein, um Schätzfehler zu vermeiden. Letztendlich demonstriert diese Studie, dass die Verwendung einer einzigen Stichprobengröße über verschiedene Weinbergsflächen kontraproduktiv ist. Vielmehr sollte die Probengröße basierend auf der beobachteten Variabilität im Weinberg bestimmt werden, wobei der beste Kompromiss zwischen Schätzfehler und Probenahmeaufwand in Bezug auf Zeit und Kosten gewählt werden muss. Sollte es möglich sein, den Variationskoeffizienten während der Stichprobenerhebung in Echtzeit zu berechnen, können die in diesem Bericht vorgestellten Ressourcen genutzt werden, um die mit einer Probenahme verbundene Präzision zu bestimmen und die Protokolle entsprechend anzupassen.
Danksagungen: Diese Arbeit wurde von der Occitanie Region finanziert.
Fußnoten
- 1. Oger, B., Laurent, C., Vismara, P., & Tisseyre, B. (2023a). How to better estimate bunch number at vineyard level? OENO One, 57(3), 27-39. https://doi.org/10.20870/oeno-one.2023.57.3.7404
- 2. Oger, B., Zhang, Y., Gras, J. P., Valloo, Y., Faure, P., Brunel, G., & Tisseyre, B. (2023b). High spatial resolution dataset of grapevine yield components at the within-field level. Data in Brief, 50, 109580. https://doi.org/10.1016/j.dib.2023.109580
- 3. Oger, B., Laurent, C., Vismara, P., & Tisseyre, B. (2023a). How to better estimate bunch number at vineyard level? OENO One, 57(3), 27-39. https://doi.org/10.20870/oeno-one.2023.57.3.7404
- 4. Oger, B., Laurent, C., Vismara, P., & Tisseyre, B. (2024). Sampling to estimate the average number of bunches per vine: table of confidence intervals for estimation errors. Zenodo. https://doi.org/10.5281/zenodo.10594995
Literaturhinweise
- Laurent, C., Oger, B., Taylor, J. A., Scholasch, T., Metay, A., & Tisseyre, B. (2021). A review of the issues, methods and perspectives for yield estimation, prediction and forecasting in viticulture. European Journal of Agronomy, 130, 126339. https://doi.org/10.1016/j.eja.2021.126339
- Oger, B., Laurent, C., Vismara, P., & Tisseyre, B. (2023a). How to better estimate bunch number at vineyard level? OENO One, 57(3), 27-39. https://doi.org/10.20870/oeno-one.2023.57.3.7404
- Oger, B., Zhang, Y., Gras, J. P., Valloo, Y., Faure, P., Brunel, G., & Tisseyre, B. (2023b). High spatial resolution dataset of grapevine yield components at the within-field level. Data in Brief, 50, 109580. https://doi.org/10.1016/j.dib.2023.109580
- Oger, B., Laurent, C., Vismara, P., & Tisseyre, B. (2024). Sampling to estimate the average number of bunches per vine: table of confidence intervals for estimation errors. Zenodo. https://doi.org/10.5281/zenodo.10594995
Artikelstatistik
 Ansichten: 2642
Downloads
 XML: 19